
Как подготовить MVP к масштабированию: архитектура, нагрузка и команда
Содержание статьи
Масштабирование начинается с проверки спроса, метрик и архитектуры. В статье вы найдёте признаки готовности, план работ, ориентиры по нагрузке и список ошибок. Если рабочей версии ещё нет, сначала закажите разработку MVP под ключ.
Что значит масштабировать MVP
Масштабирование - это рост проекта без потери скорости и качества. Увеличиваются аудитория, объём информации, набор возможностей и штат. Сервис должен выдерживать больше обращений, а расходы на одного клиента не должны расти.
Пользователи оценивают скорость и стабильность. Для них важно, открывается ли страница за секунду и проходит ли оплата с первой попытки. Поэтому цели масштабирования формулируйте через опыт пользователей: время ответа, доступность и число ошибок.
Масштабирование MVP затрагивает архитектуру, инфраструктуру, процессы и модель дохода. Владелец проекта должен понимать, сколько стоит каждый новый клиент. Если масштабирование делает проект убыточным, остановитесь и пересчитайте экономику.
Приток аудитории и масштабирование - разные задачи. Аудиторию приводит маркетинг. Масштабирование помогает платформе, процессам и специалистам справиться с этим притоком. Если трафик вырос, а сервис недоступен, масштабирования нет.
Первую версию создают для проверки гипотезы. Она содержит минимум возможностей и часто пишется быстро. Такое решение редко рассчитано на большую нагрузку. Поэтому переход от пробной версии к развитию требует отдельной подготовки.
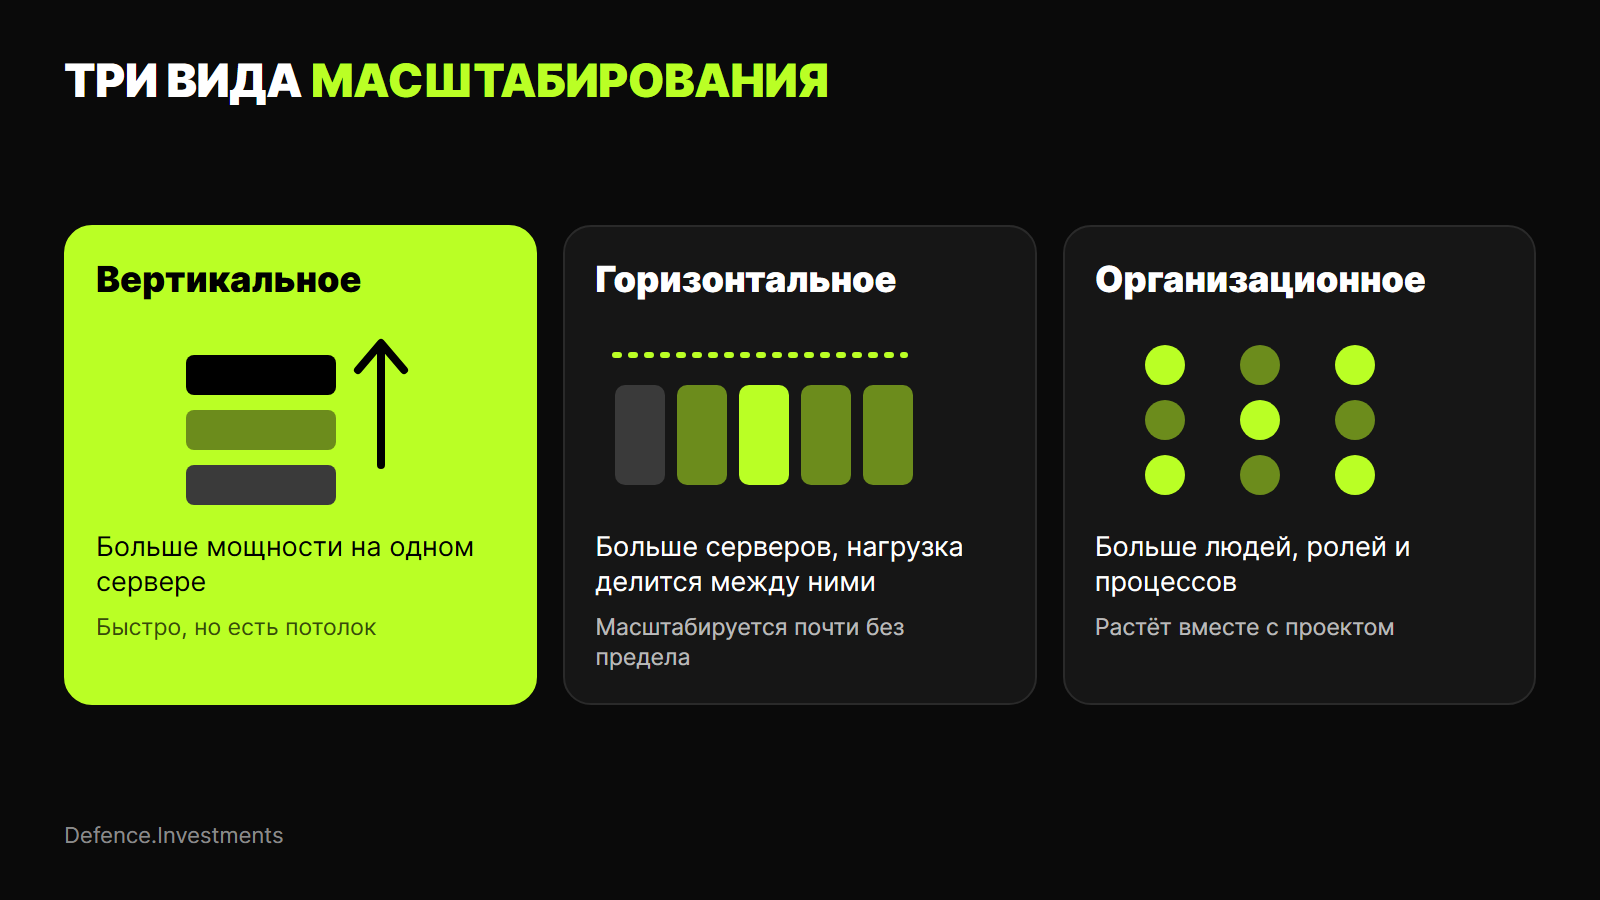
Масштабирование бывает трёх видов:
- вертикальное: больше мощности на одном сервере;
- горизонтальное: больше серверов, между которыми делится нагрузка;
- организационное: больше людей, ролей и согласованных процессов.
Обычно начинают с вертикального варианта, потому что он быстрее. У него есть потолок: мощность одного сервера конечна. Для дальнейшего развития платформу переводят на горизонтальную схему.
Признаки, что MVP готов к масштабированию
Масштабировать нужно решение, которое уже подтвердило ценность. Если спрос не проверен, расходы на серверы лишь увеличат убытки. Сначала убедитесь, что гипотеза работает.
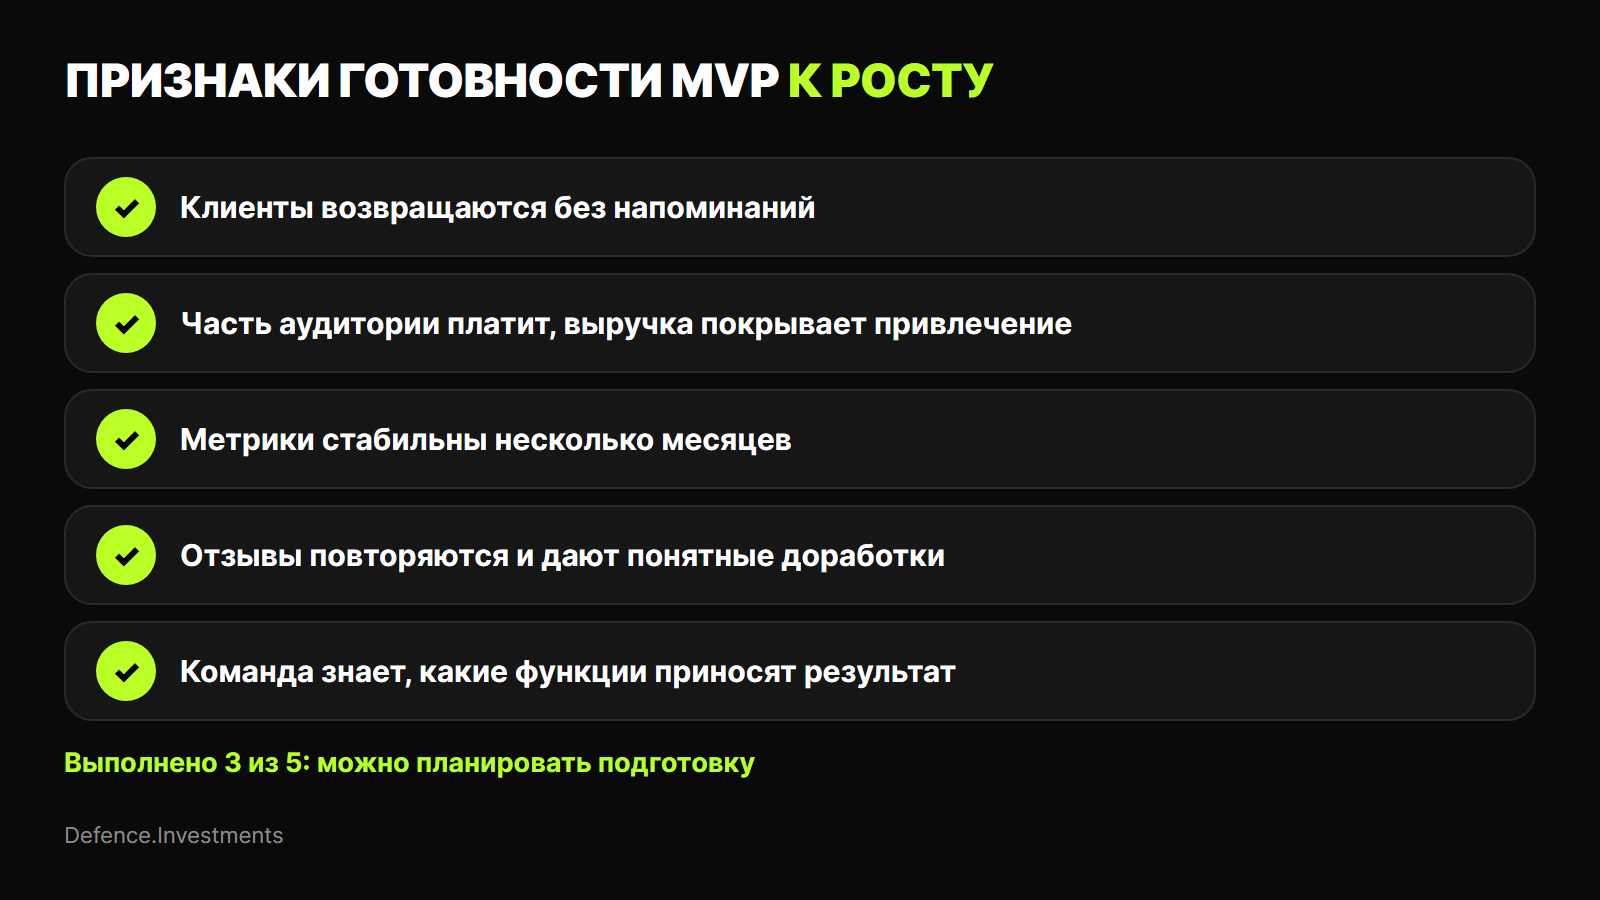
Готовность подтверждают пять признаков:
- Клиенты возвращаются без дополнительных напоминаний.
- Часть аудитории платит, а выручка покрывает расходы на привлечение.
- Ключевые метрики держатся стабильно несколько месяцев подряд.
- Отзывы повторяются и показывают понятные направления доработки.
- Команда знает, какие возможности приносят результат, а какие остаются без внимания.
Если выполнены три пункта из пяти, можно планировать подготовку. Если выполнены один или два, вернитесь к проверке гипотез. Заранее решите, какая метрика станет сигналом для старта работ.
Отдельно проанализируйте функции. Выясните, какие функции пользователи применяют чаще всего. Многие пользователи не доходят до половины возможностей первой версии. Новые функции стоит добавлять только после такого анализа. Каждая лишняя функция увеличивает стоимость поддержки и тормозит развитие.
Технические сигналы тоже важны. Страницы открываются медленнее, чем раньше. Обращения к хранилищу занимают секунды. Разработчики тратят больше времени на исправления, чем на новую работу. Эти симптомы показывают, что текущая структура подходит к пределу.
Как понять, что архитектура не выдержит рост?
Архитектура - это устройство платформы: как компоненты связаны между собой и где хранятся записи. В первой версии её строят под скорость запуска. Для первых сотен клиентов этого достаточно. При увеличении нагрузки слабые места проявляются быстро.
Запас прочности проверяют три вопроса. Сколько одновременных посетителей выдержит платформа сейчас? Что произойдёт, если нагрузка вырастет в десять раз? Сколько дней уходит на выпуск одного изменения? Если ответа нет, начните с аудита.
Технический долг и узкие места в коде
Технический долг - это накопленные упрощения в программной части. Специалисты выбирают быстрое решение вместо правильного, чтобы успеть к запуску. Пока сервис мал, долг почти незаметен. При увеличении аудитории он замедляет доработки и повышает риск сбоев.
Узкие места ограничивают производительность всей платформы. Чаще всего ими становятся:
- медленные выборки из хранилища;
- отсутствие кэширования;
- тяжёлые операции, которые выполняются прямо во время обращения клиента;
- блоки, которые невозможно проверить по отдельности;
- жёсткие связи между модулями.
Эти участки нужно найти до того, как их заметят клиенты. Для этого используйте профилирование и мониторинг. Они показывают, какие операции занимают больше всего времени.
Как провести технический аудит кодовой базы
Аудит проводит инженер, который не писал эту часть проекта. Свежий взгляд быстрее находит проблемы. Работа занимает от нескольких дней до двух недель, в зависимости от размера проекта.
Порядок действий выглядит так:
- Опишите архитектуру: модули, сервисы, хранилища, внешние интеграции.
- Запустите статический анализ и соберите список замечаний.
- Проверьте, покрыты ли тестами критичные сценарии.
- Найдите самые медленные операции.
- Оцените безопасность: доступы, хранение паролей, защиту API.
- Составьте список проблем с приоритетами и оценкой трудозатрат.
Итогом становится документ с рекомендациями. Он помогает решить, что исправить сразу, а что отложить. Тот же документ нужен для оценки бюджета и сроков.
Рефакторинг или переписывание с нуля: как выбрать
После аудита встаёт главный вопрос. Улучшать существующее решение или создать новое? Ответ зависит от состояния проекта и целей бизнеса.
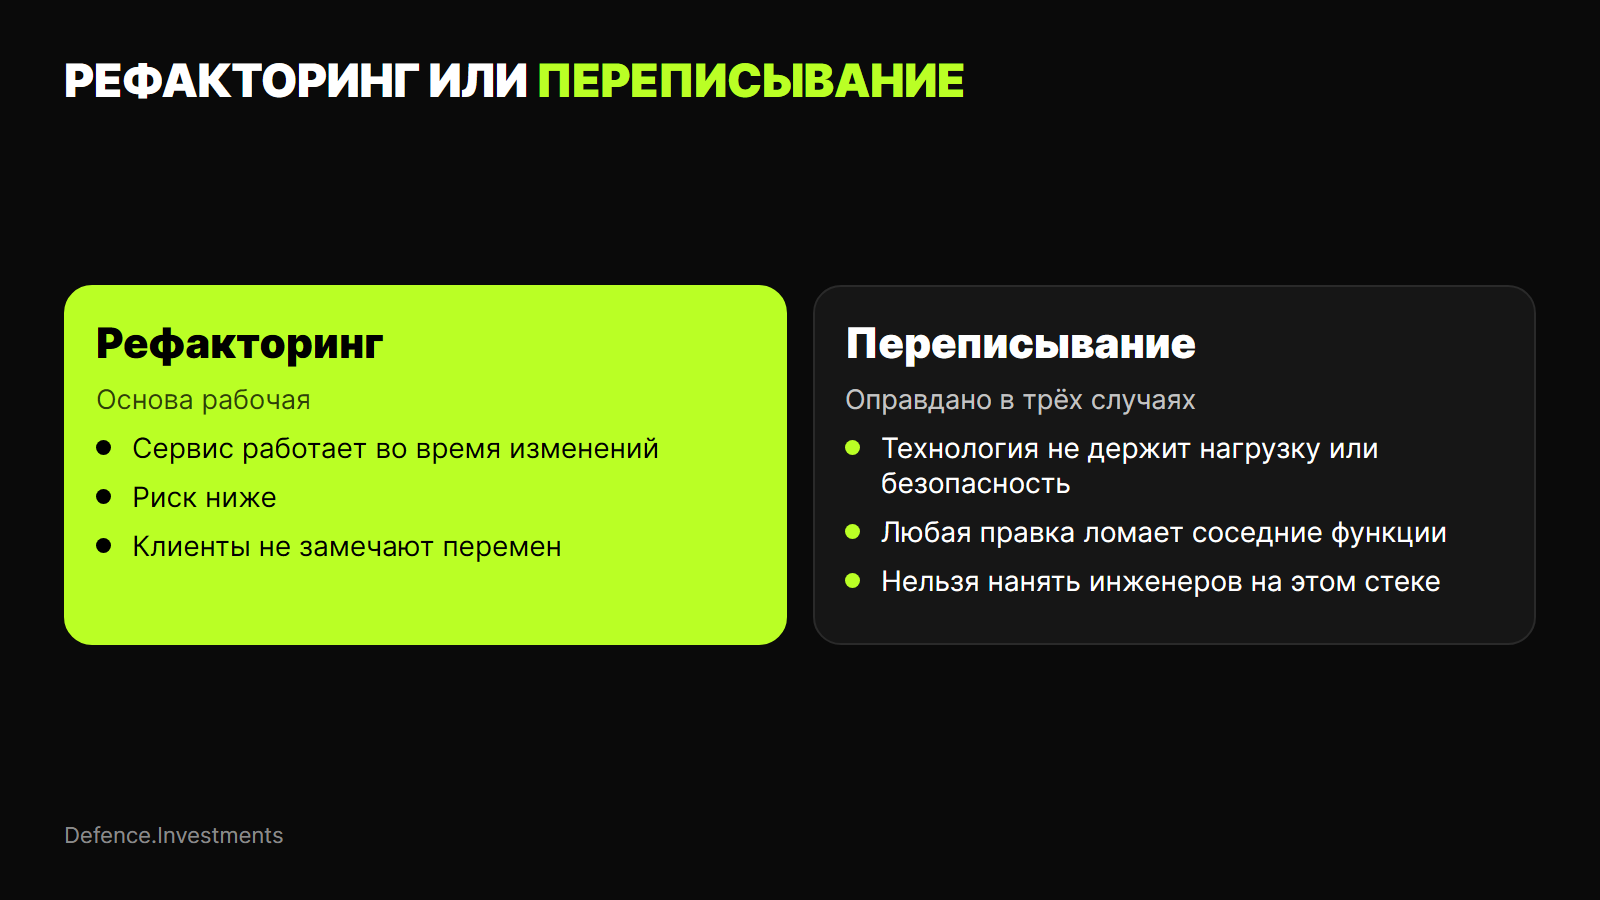
Рефакторинг - это изменение внутреннего устройства без изменения поведения. Сервис продолжает работать, пока специалисты улучшают его по частям. Риск ниже, а клиенты не замечают перемен. Этот путь подходит, если основа рабочая.
Переписывание заменяет решение целиком. Оно занимает больше времени и стоит дороже. Всё это время платформа остаётся без улучшений, и специалисты могут повторить прежние ошибки. Поэтому полная замена оправдана редко.
Переписывать стоит в трёх случаях:
- выбранная технология не выдерживает нужную нагрузку или требования безопасности;
- устройство настолько запутано, что любая правка ломает соседние возможности;
- на этом стеке невозможно нанять инженеров.
Рефакторинг идёт безопаснее при наличии тестов. Тестирование критичных сценариев защищает от регрессий. Пока автотестов нет, добавьте их до изменения кода.
Во всех остальных случаях выбирайте рефакторинг. Безопасный вариант - выделять проблемные модули и заменять их по одному. Остальная платформа работает без остановки.
Как спроектировать продукт на 100 тысяч пользователей?
Аудитория в 100 тысяч клиентов меняет требования к инфраструктуре. Появляются пики трафика, большие объёмы информации и зависимость от внешних сервисов. Решение должно справляться с этим без переписывания на каждом этапе.
Закладывайте запас по мощности. На первом этапе достаточно выдерживать нагрузку в два-три раза выше текущей. Каждые несколько месяцев пересматривайте прогноз и обновляйте план. Так продукт растёт без резких переделок.
Универсальной схемы нет, потому что нагрузка зависит от типа сервиса. Чат, интернет-магазин и финансовая платформа ведут себя по-разному. Базовые принципы совпадают: разделять ответственность, убирать единые точки отказа и измерять результат.
Модульный монолит и переход на микросервисы
Монолит - это приложение, где вся логика работает как единое целое. Для первой версии это удобный вариант: его проще создавать и выпускать. Проблемы начинаются, когда логика разрастается и модули зависят друг от друга.
Модульный монолит - промежуточный шаг. Приложение остаётся единым, но внутри делится на независимые модули с чёткими границами. Каждый модуль отвечает за свою область: платежи, профили, уведомления. Такую структуру легче развивать и позже разделять на сервисы.
Микросервисы - это набор небольших сервисов, каждый из которых работает отдельно. Они позволяют увеличивать мощность только для нагруженных частей. Цена высока: сложнее выпуск версий, мониторинг и согласование между сервисами.
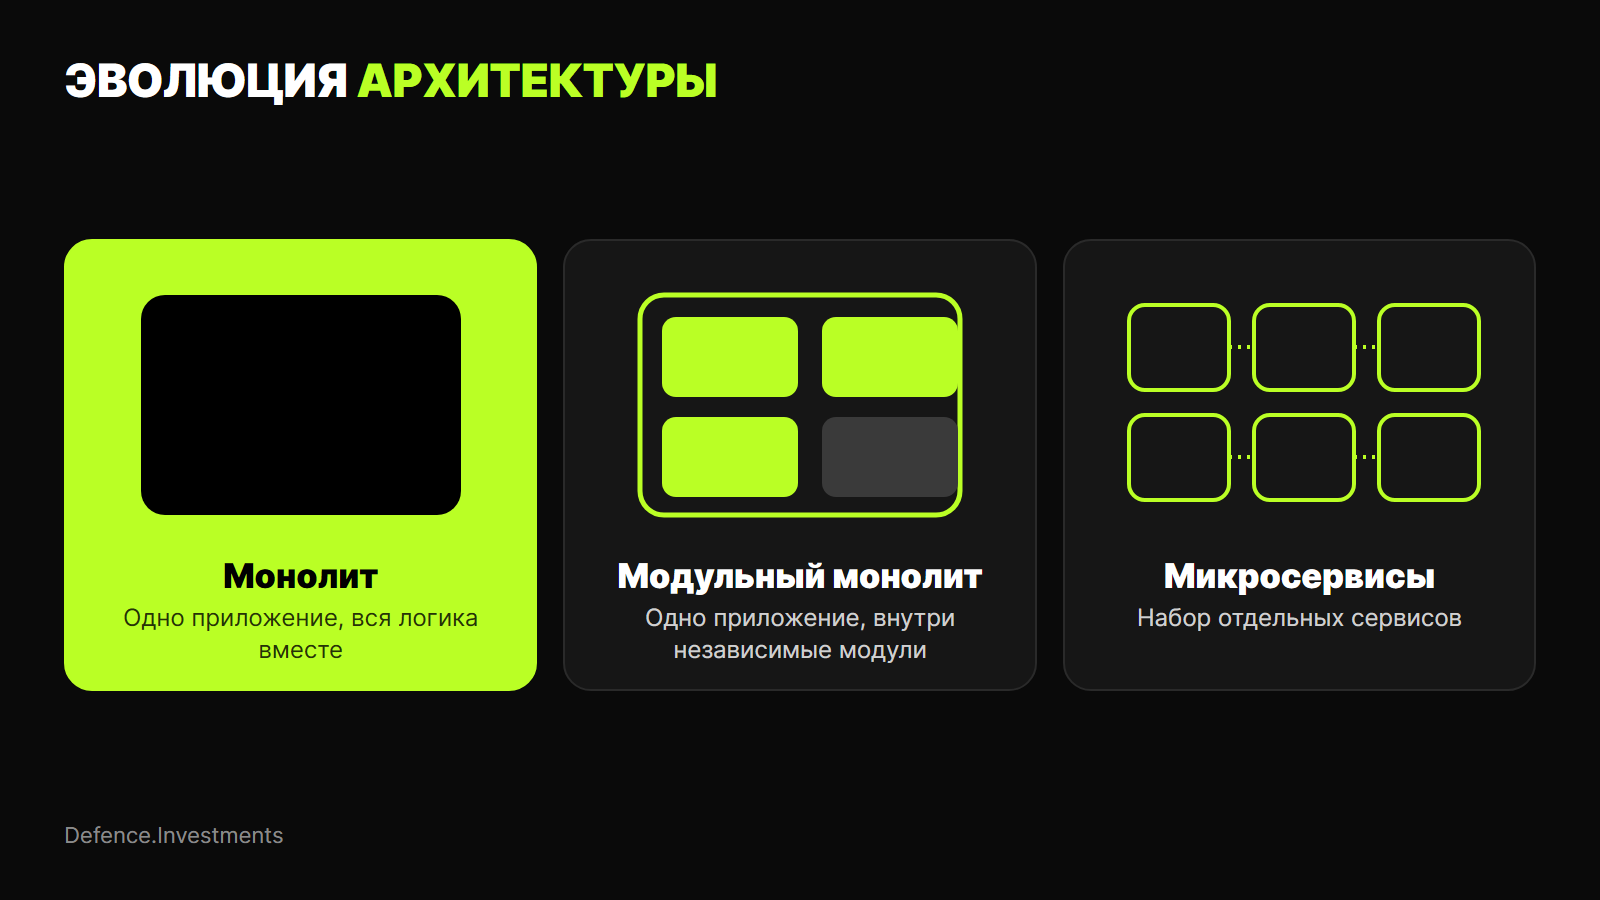
Переходить на микросервисы стоит при нескольких условиях. Над проектом работают несколько групп специалистов. Отдельные части нагружены неравномерно. Есть опыт эксплуатации распределённых сервисов. Если этих условий нет, разумным выбором остаётся модульный монолит.
API и интеграции с внешними сервисами
API - это интерфейс, через который программы обмениваются сообщениями. С увеличением аудитории через него идёт всё больше обращений. Внешние сервисы, например платёжные системы и почтовые рассылки, становятся частью вашей надёжности.
Для внешних интеграций действуют простые правила:
- задавайте тайм-аут на каждое внешнее обращение;
- повторяйте неудавшиеся вызовы с нарастающей паузой;
- выносите долгие операции в очередь задач;
- ограничивайте частоту вызовов, чтобы защититься от перегрузки;
- версионируйте API, чтобы изменения не ломали клиентские приложения.
Сначала измерьте число запросов в секунду в часы пик. Эти запросы показывают реальную нагрузку. Затем найдите запросы, которые вызывают больше всего задержек. Оптимизируйте их в первую очередь.
Эти меры снижают влияние чужих сбоев на ваш сервис. Если платёжный провайдер отвечает медленно, клиенты всё равно видят работающий интерфейс.
Масштабирование базы данных
База данных чаще всего первой достигает предела. Все обращения клиентов сходятся в одной точке, поэтому оптимизировать её нужно в первую очередь.
Базовые приёмы идут в таком порядке. Сначала добавьте индексы на поля, по которым идёт поиск и сортировка. Затем ускорьте медленные выборки, которые нашёл аудит. После этого подключите реплики для чтения: они берут на себя отчёты. Когда этого мало, записи делят между серверами по ключу, например по номеру клиента.
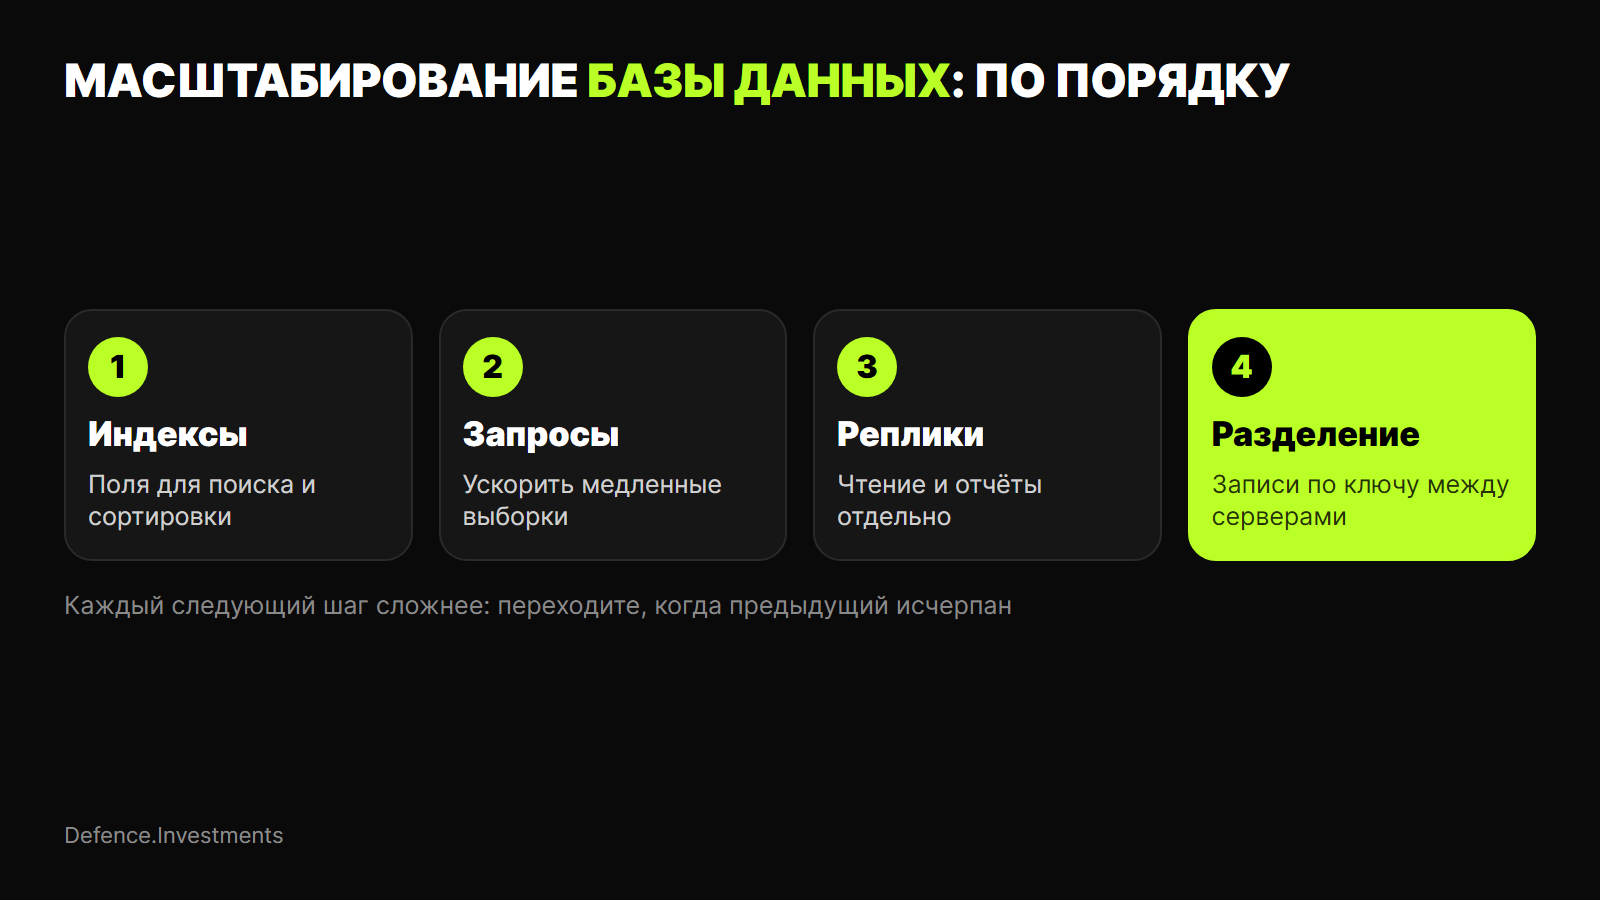
Каждый приём усложняет схему. Поэтому переходите к следующему только после того, как предыдущий исчерпан. Заранее проверьте, как изменения схемы влияют на работающий сервис: они не должны останавливать приложение.
Облачная инфраструктура, кэширование и автоматическое масштабирование
Облачные платформы, например AWS и Google Cloud, позволяют добавлять ресурсы по мере необходимости. Оборудование покупать заранее не нужно. Вы платите за то, что используете.
Кэширование сохраняет результаты частых операций в быстрой памяти. Приложение не обращается к базе повторно и отвечает быстрее. Кэшируют справочники, профили и итоги сложных расчётов. Для статических файлов используют сеть доставки контента, которая отдаёт их с ближайшего к посетителю сервера.
Описывайте инфраструктуру в виде кода. Такой подход называют Infrastructure as Code. Конфигурация хранится в репозитории, а окружение разворачивается одной командой. Это ускоряет масштабирование и снижает число ошибок.
Автоматическое масштабирование добавляет серверы при увеличении нагрузки и убирает их, когда она спадает. Для него приложение не должно хранить состояние на одном сервере. Сессии и файлы выносят во внешнее хранилище. Тогда любой сервер обработает любое обращение.
Нагрузочное тестирование и мониторинг производительности
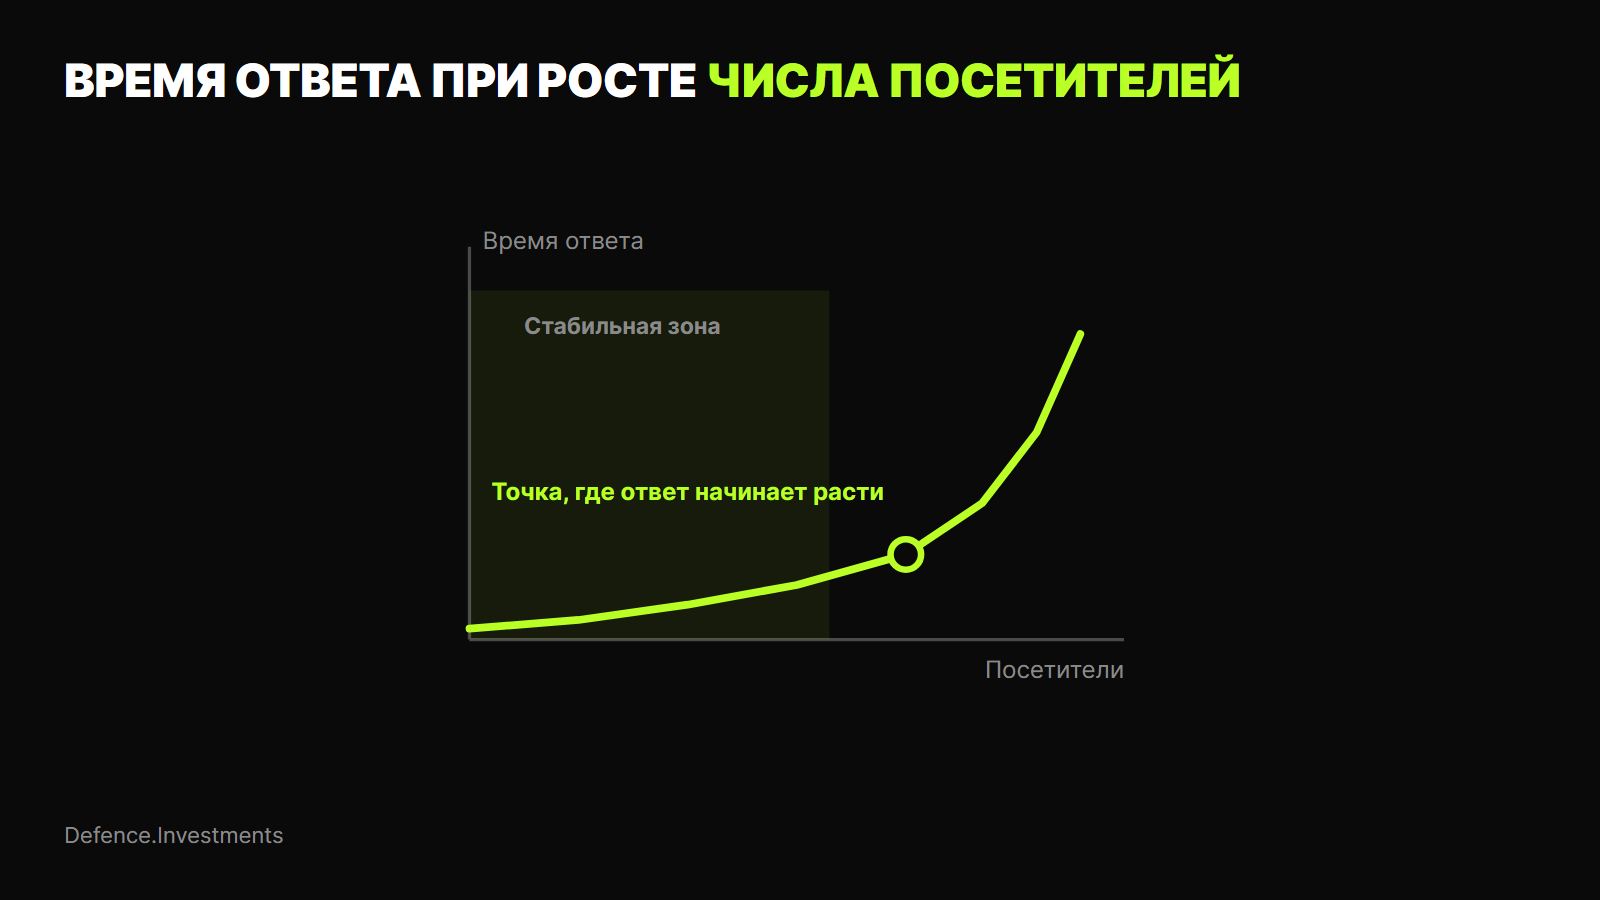
Нагрузочный тест показывает, как платформа ведёт себя при увеличении трафика. Вы создаёте искусственную нагрузку и смотрите, где появляются задержки и ошибки. Так проблемы находят до выхода к реальной аудитории.
Для этого подходят инструменты k6, Locust и JMeter. Они имитируют тысячи одновременных посетителей. Сценарии берите из реальных действий: вход, поиск, оплата. Запускайте проверки на окружении, которое повторяет рабочее.
Проверка нагрузки проходит в несколько этапов:
- Определите целевую нагрузку по плану роста.
- Запустите тест с постепенным увеличением числа посетителей.
- Зафиксируйте точку, где время ответа начинает расти.
- Найдите причину: база, сервер приложения или внешний сервис.
- Исправьте проблему и повторите тест.
Мониторинг работает постоянно, в том числе после запуска. Он собирает время ответа, число ошибок, загрузку процессора и памяти. Для этого подходят Prometheus, Grafana и Sentry. Настройте оповещения, чтобы специалисты узнавали о проблеме раньше клиентов.
Следите за показателем p95 времени ответа. Он показывает, сколько ждут 95% обращений. Среднее значение скрывает медленные случаи, а p95 их показывает.
Метрики и аналитика, которые нужно собрать до масштабирования
Без цифр решение о развитии принимают наугад. Метрики показывают, что работает, а что нет. Собирайте их заранее, чтобы иметь точку отсчёта.
Поведение аудитории описывают такие показатели:
- удержание: сколько клиентов возвращаются через день, неделю, месяц;
- активность: число активных клиентов в день и в месяц;
- конверсия: доля посетителей, которые дошли до целевого действия;
- отток: доля клиентов, которые ушли за период.
Финансовые метрики показывают экономику роста. К ним относятся стоимость привлечения клиента, выручка на одного клиента и срок окупаемости. Если привлечение стоит дороже, чем клиент приносит, рост увеличит убытки.
Технические метрики описывают состояние системы: время ответа, доля ошибок, доступность. Для каждой задайте целевое значение и проверяйте его регулярно.
Собирайте данные минимум три месяца. Короткий период даёт случайные результаты. За несколько месяцев видна сезонность и реальное поведение пользователей. Считайте метрики отдельно для новых и постоянных пользователей.
Настройте аналитику заранее. Подключите инструмент для событий и единый источник цифр. Тогда после запуска роста вы сравните результаты с исходным уровнем и поймёте, что дало эффект.
Команда на этапе роста: кого нанимать
Штат на старте обычно небольшой. Несколько разработчиков закрывают весь стек, а один человек отвечает сразу за приоритеты и аналитику. При увеличении нагрузки такая схема перестаёт работать.
Следующие роли добавляют по мере необходимости:
- технический руководитель отвечает за архитектуру и выбор технологий;
- DevOps-инженер настраивает инфраструктуру, выпуск версий и мониторинг;
- специалист по тестированию проверяет качество перед каждым релизом;
- менеджер проекта управляет приоритетами и связывает владельцев проекта с разработкой;
- аналитик работает с метриками и гипотезами;
- поддержка отвечает клиентам и собирает отзывы.
Команда растёт поэтапно. Первое время уходит на аудит и исправление слабых мест. Затем команда занимается новыми функциями и ростом нагрузки. Выделите ответственного за техническое качество, иначе команда будет постоянно переключаться между задачами.
Нанимайте под конкретную проблему. Если растёт число сбоев, нужен DevOps. Если изменения выходят медленно, нужен технический руководитель. Расширяйте штат по мере появления задач.
Другой вариант - подключить внешнюю группу. Она включается быстро и закрывает недостающие роли. Defence.Investments предлагает разработку стартапа под ключ и сопровождает проект после запуска. Более 10 лет, 30+ специалистов, 100+ реализованных проектов.
Пошаговый план подготовки MVP к масштабированию
План помогает пройти путь по порядку. Сроки зависят от размера проекта и состояния платформы, поэтому ориентируйтесь на свои цифры.
- Подтвердите спрос: проверьте удержание, оплаты и повторяющиеся отзывы.
- Соберите метрики: настройте аналитику и зафиксируйте исходные значения.
- Проведите технический аудит: найдите слабые участки, составьте список с приоритетами.
- Выберите стратегию: рефакторинг, замена модулей или переписывание.
- Спроектируйте целевую структуру: опишите модули, базу, кэш и облачные ресурсы под ожидаемую нагрузку.
- Исправьте слабые участки, начиная с базы и самых медленных операций.
- Настройте мониторинг и автоматический выпуск версий: подключите оповещения.
- Проведите нагрузочный тест на целевой нагрузке.
- Усильте штат: добавьте недостающие роли.
- Запускайте рост поэтапно: увеличивайте трафик частями и следите за метриками.
Для небольшого проекта ориентир выглядит так. Первый месяц уходит на метрики и аудит. Второй и третий месяцы занимает исправление слабых участков. На четвёртый месяц приходятся нагрузочный тест и поэтапный запуск. Реальные сроки зависят от проекта.
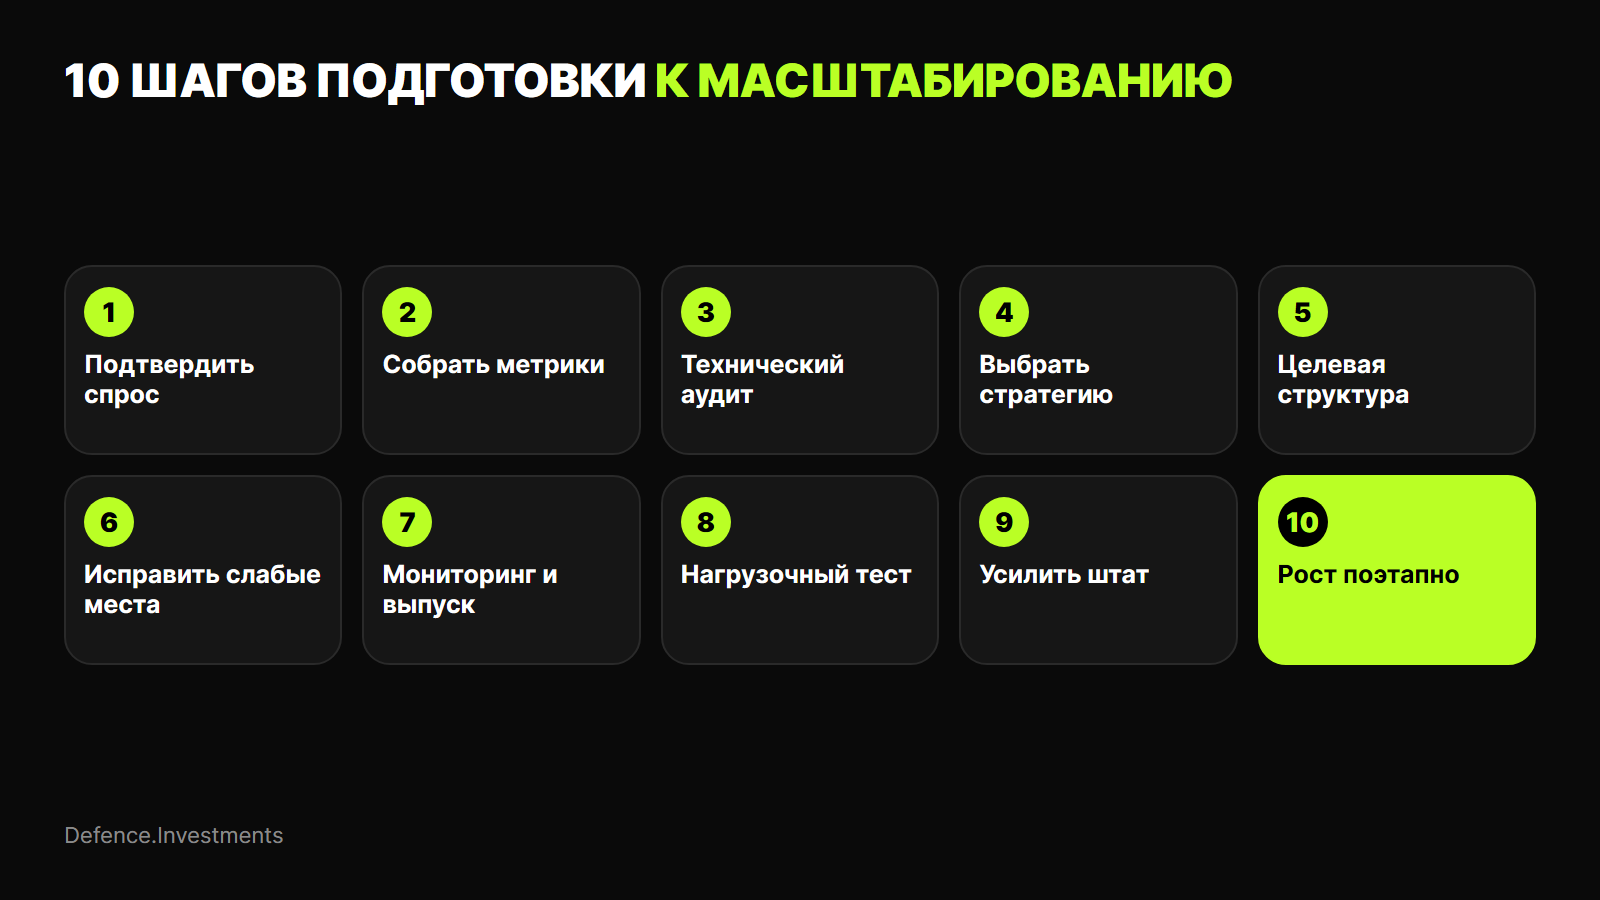
Каждый этап даёт результат, который можно проверить. Если на каком-то шаге метрики ухудшаются, остановитесь и найдите причину. Так вы сохраните накопленное.
Сколько стоит масштабирование MVP
Единой цены нет. Стоимость зависит от размера проекта, состояния архитектуры и целевой нагрузки. Две системы с одинаковой аудиторией могут требовать разного объёма работ.
На бюджет влияют следующие факторы:
- результат аудита и объём найденных проблем;
- выбранная стратегия: рефакторинг дешевле переписывания;
- целевая нагрузка и требования к доступности;
- стоимость облачных ресурсов и лицензий сервисов;
- состав и размер штата;
- требования безопасности и регуляторные требования.
Планируйте расходы на облако отдельно. Они растут вместе с нагрузкой и продолжаются после запуска. Закладывайте запас на неожиданные работы: при аудите почти всегда находятся дополнительные задачи.
Точную оценку даёт аудит проекта. Defence.Investments оценивает проект бесплатно. Стоимость и сроки фиксируются до старта работ.
Особенности масштабирования финтех-продуктов
Финтех-сервисы работают с деньгами и персональной информацией. Поэтому к ним предъявляют дополнительные требования. Ошибка в расчётах или утечка обходится дороже, чем в обычном приложении.
На что обратить внимание:
- Целостность операций. Каждая операция выполняется полностью или не выполняется вовсе. Для этого используют транзакции базы и проверки на дубли.
- Безопасность. Шифруйте информацию при хранении и передаче, разграничивайте доступы и ведите журнал действий.
- Проверка клиентов. Процедуры KYC и AML должны выдерживать рост числа регистраций.
- Отчётность и аудит. Платформа хранит историю операций и выдаёт её по требованию.
- Требования регуляторов. Они зависят от страны и вида деятельности, поэтому уточняйте их у профильных юристов.
Пользователи финтех-продуктов особенно чувствительны к сбоям. Задержка перевода на несколько минут вызывает обращения в поддержку. Поэтому доступность платёжных функций ставят в приоритет.
Нагрузочный тест финтех-сервиса проводите на сценариях с платежами. Проверьте поведение при сбое платёжного провайдера. Команда Defence.Investments помогает с технической частью, а юридические вопросы решают профильные юристы.
Частые ошибки при масштабировании MVP
Большинство проблем повторяются от проекта к проекту. Знание типичных ошибок помогает их избежать.
Самые частые из них:
- Масштабирование до подтверждения спроса. Деньги уходят на серверы для клиентов, которых ещё нет.
- Преждевременные микросервисы. Усложнение приходит сразу, выгода появляется позже.
- Полное переписывание без необходимости. Проект замирает на месяцы, пока конкуренты идут вперёд.
- Отсутствие метрик. Нельзя понять, помогли ли изменения.
- Откладывание работ с базой. Её оптимизируют последней, хотя проблемы начинаются именно там.
- Нагрузочный тест на нереалистичных сценариях. Результат расходится с рабочей ситуацией.
- Игнорирование отзывов пользователей. Новые функции появляются, а старые проблемы остаются.
- Отсутствие плана отката. Неудачный релиз приводит к долгому простою.
Любую из этих ошибок проще предотвратить, чем исправить. Перед каждым этапом спрашивайте себя, какие данные подтверждают решение. Если ответа нет, соберите факты и только потом переходите к следующему шагу.
Большинство ошибок связано с порядком действий. Сначала спрос и цифры, затем архитектура, потом рост.
Вопросы и ответы
Когда начинать масштабирование MVP?
Начинайте, когда проект подтвердил ценность. Клиенты возвращаются, часть из них платит, а метрики стабильны. Техническую подготовку можно начать раньше, за несколько месяцев до ожидаемого роста. Тогда к приходу нагрузки платформа уже готова.
Нужно ли переписывать MVP с нуля?
Обычно нет. Рефакторинг по частям безопаснее и дешевле. Сервис продолжает работать, а специалисты улучшают самые проблемные модули. Переписывание оправдано, если технология не подходит или решение невозможно развивать.
Сколько времени занимает подготовка к масштабированию?
Срок зависит от размера проекта и состояния платформы. Аудит занимает от нескольких дней до двух недель. Исправление слабых участков и настройка инфраструктуры занимают от одного до нескольких месяцев. Точный срок называют после аудита.
Когда переходить на микросервисы?
Переходите, когда над проектом работают несколько групп, а нагрузка на части платформы неравномерна. Нужен также опыт эксплуатации распределённых сервисов. Если этих условий нет, подойдёт модульный монолит.
Какую нагрузку должен выдерживать проект?
Целевую нагрузку определяют по плану роста. Возьмите ожидаемую аудиторию и добавьте запас на пиковые периоды. Затем проверьте результат нагрузочным тестом. Универсальной цифры нет, потому что она зависит от сервиса.
Можно ли масштабировать MVP без собственной команды разработки?
Да. Аудит, архитектуру и реализацию может выполнить внешняя группа. Важно передать ей метрики и понятные цели. После запуска нужен человек, который отвечает за приоритеты в вашей компании.
 0
 1
 20 октября 2026 г.


Комментарии 0